Engenheiro de Dados
Constrói e mantém pipelines, revisa o impacto de uma mudança antes de qualquer deploy, e entende schema e lineage real via Unity Catalog.
Dados + IA, para todo o time
CosmosData conecta ao Git e ao Databricks entendendo o contexto de quem constrói pipelines, quem analisa métricas e quem treina modelos, com auditoria e guardrails embutidos, não como um extra.
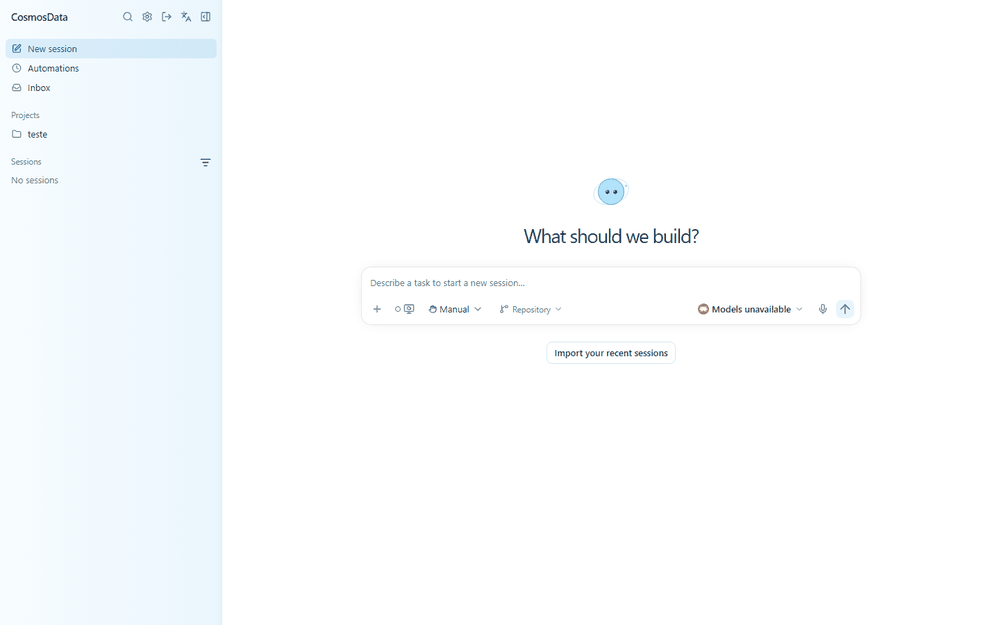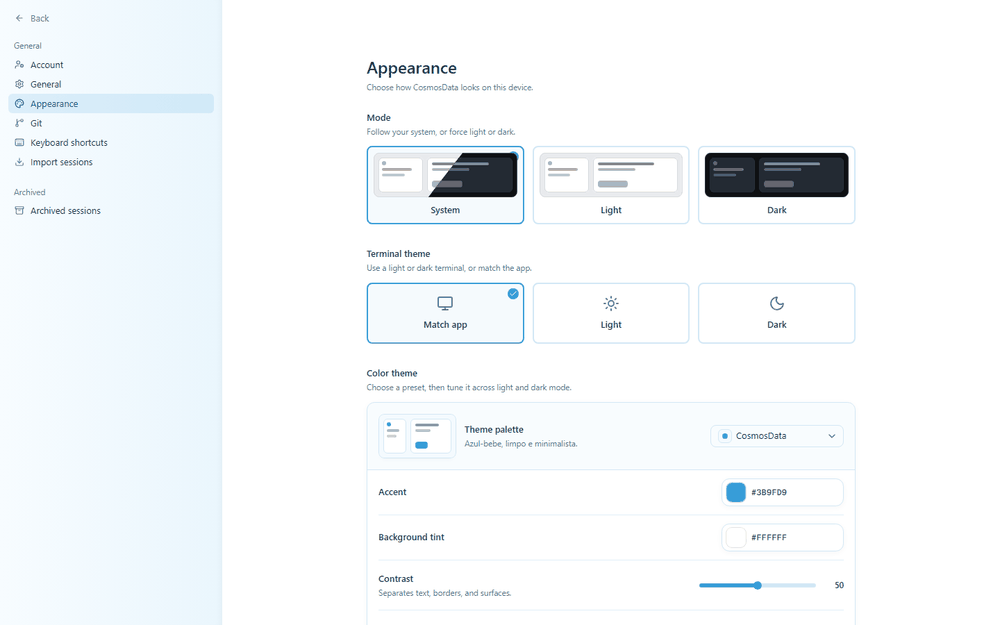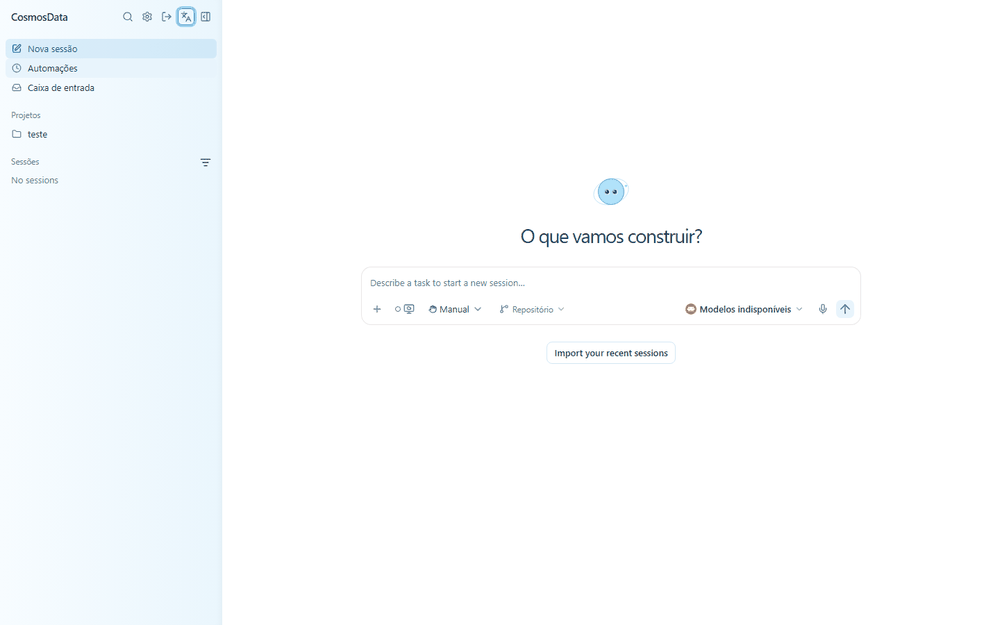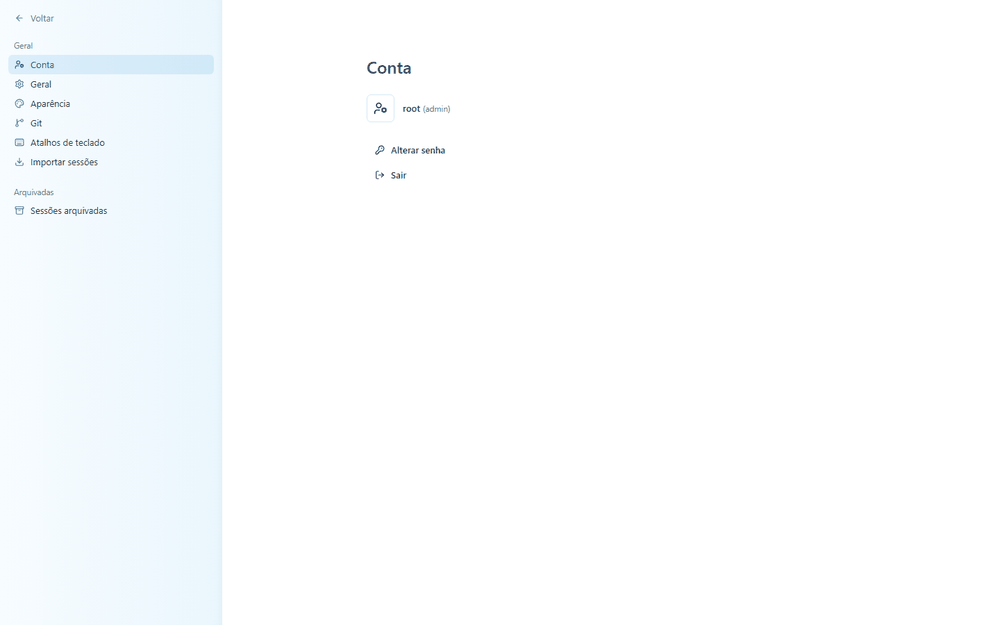
Cada perfil traz o método e as ferramentas certas pro que essa função faz no dia a dia, não um chat genérico tentando servir todo mundo igual.
Constrói e mantém pipelines, revisa o impacto de uma mudança antes de qualquer deploy, e entende schema e lineage real via Unity Catalog.
Faz perguntas em linguagem natural sobre os dados, explora métricas e monta relatórios sem depender da fila do time de engenharia.
Explora features, monta datasets prontos pra modelo, e valida a qualidade dos dados antes de treinar.
Lê o diff real (git/gh), aponta quais tabelas um PR passa a ler ou escrever, e segue a metodologia de um engenheiro sênior: nunca assume schema, sempre confirma antes de agir.
Usa os Managed MCP nativos da Databricks (Unity Catalog functions, SQL, Genie) com a identidade real do usuário via OAuth, sem token compartilhado e sem servidor extra pra manter.
Toda autenticação e execução fica registrada numa tabela de controle no Unity Catalog, e mudanças destrutivas (DROP, TRUNCATE, DELETE sem WHERE) pedem confirmação antes de rodar.
Interface em português, com paleta e identidade visual próprias, pensada pra times que trabalham em português no dia a dia.
Aponte o CosmosData pro seu repositório de pipelines: ele clona e trabalha direto nele.
"Analise o impacto desse PR", "crie um pipeline DLT pra essa fonte", "por que esse job ficou caro".
O agente propõe, explica o raciocínio, e só executa mudanças sensíveis com sua confirmação.